StackOverflow-代码实体识别
原文标题:Code and Named Entity Recognition in StackOverflow
原文作者: Jeniya Tabassum, Mounica Maddela, Wei Xu, Alan Ritter
发表期刊: ACL Anthology
原文链接:https://arxiv.org/pdf/2005.01634
研究背景
大量的编程文本语料库在互联网上很容易获得,但仍然缺乏基本的自然语言处理技术来识别代码标记或与软件相关的命名实体。
主要贡献
- StackOverflow NER语料库: 手动标注了20种类型的命名实体,包括自然语言句子中的所有内联代码
- 域内训练的神经NER标记器: 识别20个与软件开发相关的20个细粒度命名实体
- 代码令牌识别器:利用StackOveflow代码片段来捕获与代码相关的实体的字符模式,并持续改进NER标记器。
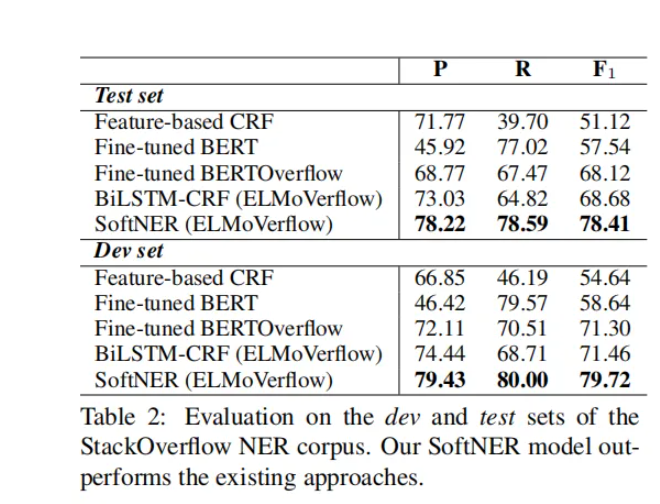
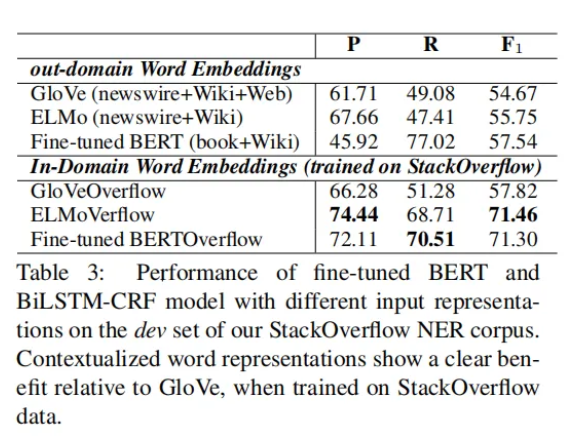
- 域内训练ELMo和BERT:F1得分比现有的ELMo增加了14分以上,并显著优于现成的BERT。
命名实体标记器在提取20种软件相关的命名实体类型时,在StackOverflow上获得了78.41%的F1分数,在GitHub数据上获得了62.69%的F1分数。
具体实现
StackOverflow 语料库注释
定义并注释20种细粒度实体,其中8个与代码相关的实体,12个自然语言实体。同时每个实体的定义都是鼓励最大跨度长度。一个实体平均包含大约1.5个tokens。
为了更好地理解工作的领域适应性,进进一步标注了来自 GitHub 数据集中 143 个随机抽样仓库的 README 文件和问题报告
实现了一个新的分词器,以 Twokenizer3 为起点,并添加了额外的正则表达式规则,以避免将与代码相关的标记拆分。
SoftNER
该模型利用句子上下文来消除歧义,并利用领域特定的字符表示来处理稀有单词。
模型的主要结构
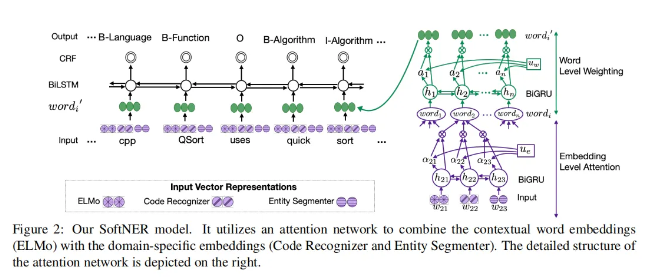
该模型有三部分构成:
- 嵌入提取层(embedding extraction layer):为输入句子中的每个单词创建上下文化的ELMo嵌入和两个新的特定于领域的嵌入。
- 多层次注意层(multi-level attention layer):使用嵌入级和单词级注意网络结合这三个单词嵌入。
- 双向长短期记忆网络-条件随机场层(BiLSTM-CRF):使用来自前一层的加权单词表示来预测每个单词的实体类型。
实验结果
模型在StackOverflow NER语料库上的性能比较:
域内域外词嵌入性能比较:
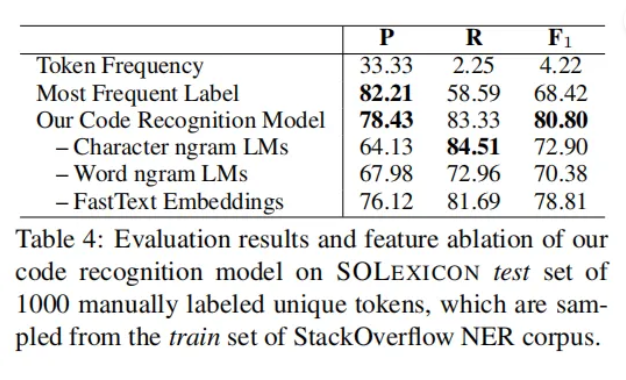
代码识别模型比较:
展望
未来将探索半监督学习和其他领域的自适应方法,实现对实体识别。
StackOverflow-代码实体识别
https://ledraw.github.io/2024/10/13/StackOverflow-代码实体识别/